


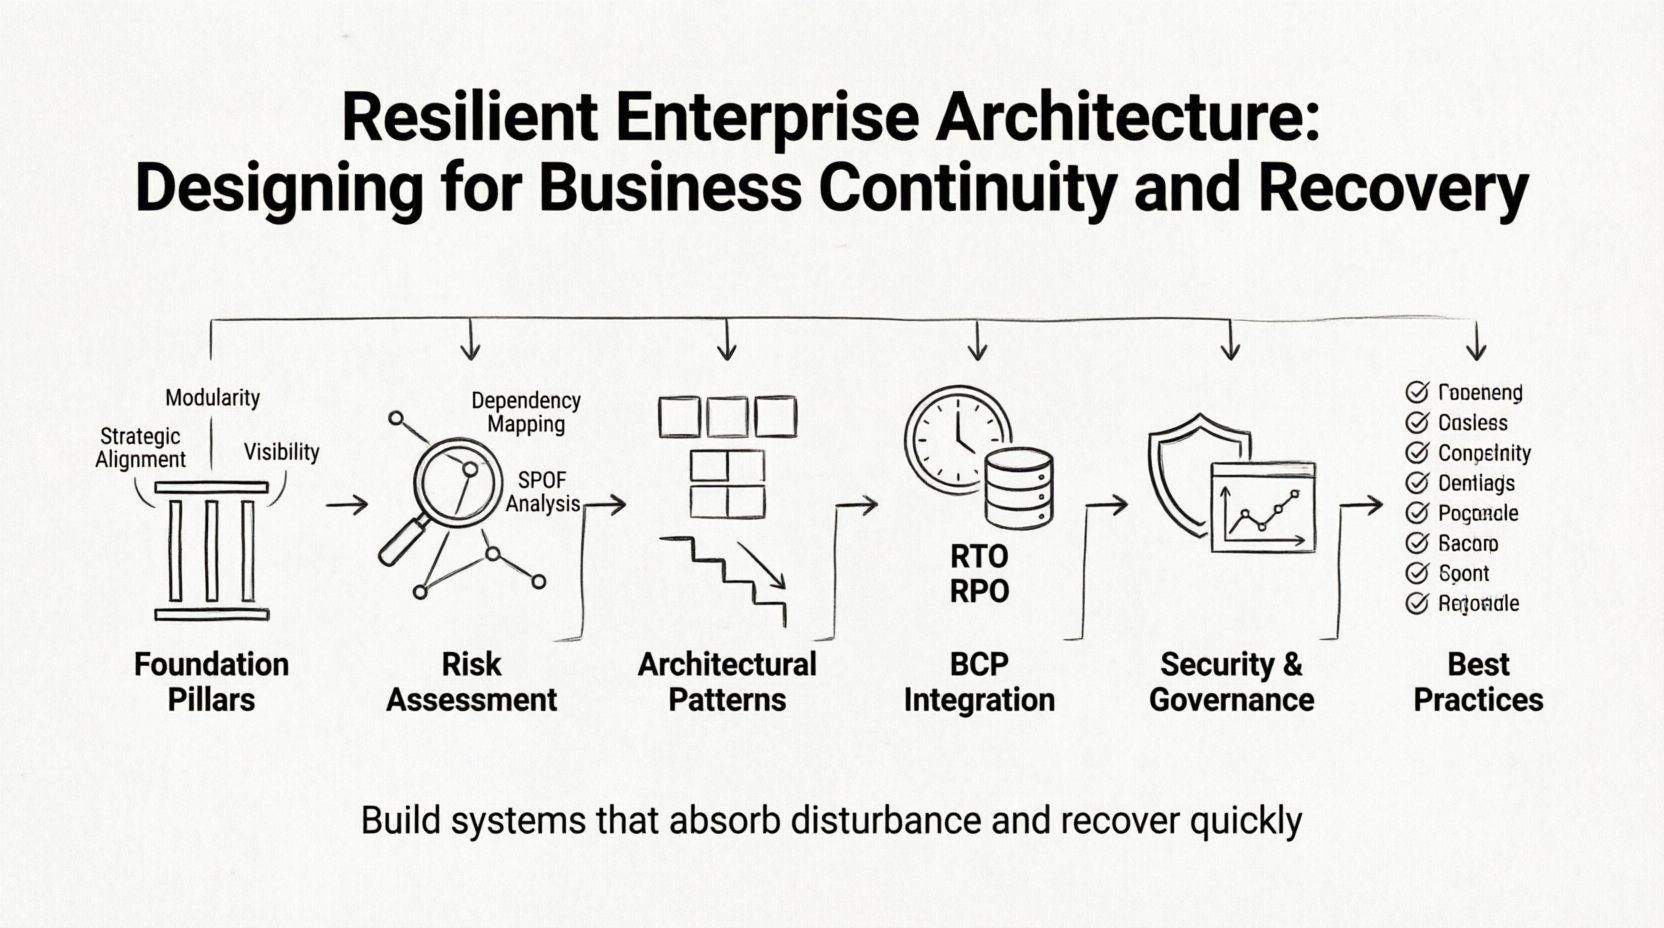
В современной цифровой среде стабильность — это не роскошь, а фундаментальная необходимость. Организации сталкиваются с постоянным потоком сбоев, от киберугроз и отказов инфраструктуры до геополитических сдвигов и прерываний в цепочках поставок.Устойчивая корпоративная архитектураслужит планом для навигации в условиях неопределенности. Это практика проектирования систем, которые не просто выживают при ударах, но продолжают эффективно функционировать во время и после неблагоприятных событий.
Настоящее руководство исследует ключевые компоненты построения архитектуры, способной поддерживать бизнес-операции. Мы выйдем за рамки базовой избыточности, чтобы обсудить стратегическое согласование, управление рисками и интеграцию планирования непрерывности в саму ткань технического проектирования. Цель состоит в создании систем, которые являются надежными, адаптивными и согласованными с долгосрочными организационными целями.
🧱 Основы устойчивой архитектуры
Устойчивость отличается от надежности. Надежность гарантирует, что система работает, когда она должна. Устойчивость гарантирует, что система работает даже при сбоях. Это способность поглощать возмущения и быстро восстанавливаться. Для достижения этого архитекторы должны рассматривать организацию как целостную экосистему, а не как набор изолированных силосов.
Ключевые столпы устойчивости
Построение устойчивой рамки требует внимания к трем различным, но взаимосвязанным областям:
- Стратегическое согласование:Технологические решения должны поддерживать бизнес-цели. Если бизнес ставит во главу угла доверие клиентов, архитектура должна приоритизировать безопасность и доступность данных.
- Модульность:Системы должны быть разбиты на независимые компоненты. Это предотвращает распространение сбоя в одном модуле на всю среду.
- Видимость:Вы не можете управлять тем, что не видите. Всесторонний мониторинг и ведение журналов необходимы для раннего обнаружения аномалий.
Понимание аппетита к риску
Каждая организация имеет разную толерантность к риску. Некоторые секторы требуют практически нулевого времени простоя, в то время как другие могут терпеть кратковременные перерывы. Определение этогоаппетита к рискуявляется первым шагом в проектировании архитектуры. Оно диктует инвестиции, необходимые для избыточности, стратегий резервного копирования и целей времени восстановления.
| Категория риска | Уровень воздействия | Архитектурный ответ |
|---|---|---|
| Отказ критической инфраструктуры | Высокий | Активно-активная избыточность в разных географических регионах |
| Повреждение данных | Средний | Неизменяемые резервные копии с версионированием |
| Задержка сети | Низкий | Стратегии балансировки нагрузки и кэширования |
| Человеческий фактор | Средний | Автоматизированные ограничители и рабочие процессы согласования |
📊 Выявление и оценка уязвимостей
Прежде чем разрабатывать средства защиты, необходимо понять угрозы. Тщательная оценка позволяет выявить слабые места. Этот процесс включает картирование зависимостей и понимание того, как данные перемещаются по организации.
Картирование зависимостей
Сложные системы часто зависят от фоновых сервисов, которые не всегда очевидны. Сбой в стороннем API, конкретном экземпляре базы данных или точке интеграции с устаревшими системами может остановить работу. Архитекторы должны создавать подробные карты этих взаимосвязей.
- Прямые зависимости (источники): Что питает систему? (например, источники данных, поставщики аутентификации).
- Нисходящие зависимости (потребители): Что зависит от системы? (например, инструменты отчетности, клиентские приложения).
- Горизонтальные зависимости: Другие сервисы в той же среде, которые используют общие ресурсы.
Анализ единой точки отказа (SPOF)
Единая точка отказа — это компонент, сбой которого останавливает весь процесс. Выявление таких точек является критически важной задачей в инженерии отказоустойчивости. К типичным областям риска относятся:
- Централизованные базы данных без репликации.
- Монолитные приложения, которые не могут масштабироваться независимо.
- Точки ручного вмешательства, которые вносят человеческий фактор.
- Сетевые узкие места, ограничивающие пропускную способность или доступ.
После выявления эти точки необходимо устранить с помощью избыточности, автоматизации или рефакторинга архитектуры. Цель состоит в том, чтобы распределить риски так, чтобы ни один отдельный сбой не вызывал катастрофического простоя.
🛡️ Архитектурные паттерны для обеспечения непрерывности
Определенные паттерны проектирования доказали свою эффективность в поддержании доступности во время сбоев. Эти паттерны следует учитывать на этапе планирования, чтобы архитектура была изначально отказоустойчивой.
Развязка сервисов
Тесная связность создает хрупкость. Когда компоненты сильно зависят от внутренних деталей реализации друг друга, изменения или сбои быстро распространяются. Развязка позволяет сервисам функцилировать независимо. Это часто достигается с помощью:
- Очереди сообщений:Асинхронная коммуникация гарантирует, что если потребитель недоступен, сообщения остаются в очереди, а не теряются.
- API-шлюзы:Они действуют как посредники, обрабатывая маршрутизацию трафика, ограничение частоты запросов и аутентификацию, не раскрывая логику бэкенда.
- Архитектура, управляемая событиями:Системы реагируют на изменения состояния, а не ждут запросов, что обеспечивает более гибкую обработку.
Избыточность и переключение при сбое
Избыточность означает наличие резервных копий. Переключение при сбое — это процесс автоматического перехода на эти резервные копии. Существует несколько стратегий для её реализации:
- Активно-пассивная:Одна система обрабатывает трафик, пока другая находится в режиме ожидания. Это экономически выгодно, но вносит задержку при переключении.
- Активно-активная:Несколько систем одновременно обрабатывают трафик. Если одна из них выходит из строя, остальные берут на себя нагрузку. Это обеспечивает более высокую доступность, но требует больше ресурсов.
- Геоизбыточность:Размещение инфраструктуры в разных физических локациях защищает от региональных катастроф, таких как стихийные бедствия или сбои в энергосетях.
Плавная деградация
Когда система не может работать на полную мощность, она должна плавно деградировать, а не аварийно завершаться. Это означает отключение неосновных функций для сохранения базовой функциональности. Например, если система рекомендаций выходит из строя, пользователь всё равно должен иметь возможность просматривать товары, даже если персонализированные предложения не отображаются.
📋 Интеграция планирования непрерывности бизнеса (ПНБ)
Планирование непрерывности бизнеса часто рассматривается как отдельный документ, но оно должно быть интегрировано в архитектуру. Технические средства контроля должны обеспечивать соблюдение бизнес-правил, определённых в ПНБ.
Определение RTO и RPO
Два ключевых показателя определяют усилия по обеспечению непрерывности:
- Целевое время восстановления (RTO):Максимально допустимое время простоя. Как долго бизнес может функционировать без этой системы?
- Целевая точка восстановления (RPO):Максимально допустимая потеря данных. Сколько данных может быть потеряно до того, как это повлияет на операции?
| Критичность системы | Целевое RTO | Целевое RPO | Стратегия |
|---|---|---|---|
| Транзакция, ориентированная на клиента | < 5 минут | < 1 минуты | Репликация в реальном времени, активно-активная |
| Внутренняя отчётность | < 24 часов | < 24 часов | Резервное копирование на удалённом объекте, запланированное восстановление |
| Среда разработки | < 1 недели | < 1 недели | Восстановление из снимка, ручное вмешательство |
Автоматизация восстановления
Ручные процессы восстановления медленны и подвержены ошибкам. В кризисной ситуации уровень стресса высок, и процедуры должны выполняться быстро. Автоматизация шагов восстановления обеспечивает согласованность и скорость. Это включает:
- Автоматическое переключение на резервную систему на основе проверок работоспособности.
- Автоматическое выделение новых ресурсов с помощью скриптов.
- Управление конфигурацией для обеспечения идентичности сред.
🔄 Стратегии и выполнение восстановления
Наличия плана недостаточно. Способность реализовать этот план определяет устойчивость. Стратегии восстановления должны регулярно тестироваться, чтобы убедиться в их эффективности.
Протоколы тестирования
Регулярное тестирование подтверждает способность архитектуры выдерживать сбои. Различные типы тестов служат разным целям:
- Настольные учения:Члены команды обсуждают сценарии и проходят по шагам реагирования без внесения технических изменений.
- Симуляция:Моделирование сбоя в среде, не связанной с производством, для проверки процессов.
- Инженерия хаоса:Намеренное внедрение сбоев в производственную систему для наблюдения за её реакцией и выявления слабых мест.
Каналы связи
Во время инцидента поток информации имеет критическое значение. Архитекторы должны проектировать системы, обеспечивающие связь даже при отказе основных каналов. Это включает:
- Инструменты связи вне основного канала (например, SMS, выделенные каналы оповещения).
- Заранее определённые роли и обязанности при инцидентах.
- Страницы статуса, обеспечивающие прозрачность для заинтересованных сторон и клиентов.
🔒 Безопасность как основа устойчивости
Безопасность и устойчивость неразделимы. Кибератака является основной причиной сбоев. Следовательно, средства защиты должны быть спроектированы для обеспечения непрерывности.
Архитектура нулевого доверия
Традиционная модель безопасности на основе периметра недостаточна для современных сред. Архитектура нулевого доверия предполагает, что угрозы существуют как внутри, так и за пределами сети. Каждый запрос на доступ проверяется независимо от источника. Это ограничивает распространение вредоносного ПО или несанкционированный доступ.
- Проверка идентификации:Многофакторная аутентификация для всех пользователей и сервисов.
- Принцип наименьших привилегий:Пользователи и сервисы имеют доступ только к тем конкретным ресурсам, которые им необходимы.
- Микросегментация:Разделение сети на небольшие зоны для локализации нарушений.
Защита данных и шифрование
Защита данных гарантирует, что даже в случае компрометации систем информация останется в безопасности. Шифрование должно применяться как для данных в состоянии покоя, так и для данных в процессе передачи. Резервные копии должны быть неизменяемыми, то есть их нельзя изменять или удалять, что защищает от программ-вымогателей, нацеленных на файлы резервных копий.
📈 Управление и управление жизненным циклом
Устойчивость — это не разовый проект; это непрерывная дисциплина. Управление гарантирует, что стандарты устойчивости поддерживаются по мере эволюции архитектуры.
Управление изменениями
Изменения являются наиболее частой причиной сбоев. Надежный процесс управления изменениями проверяет каждое изменение на предмет потенциального влияния на устойчивость. Это включает:
- Проверка зависимостей перед развертыванием.
- Обеспечение наличия планов отката.
- Проверка изменений конфигурации на соответствие базовым уровням безопасности.
Непрерывный мониторинг
Мониторинг предоставляет данные, необходимые для поддержания здоровья системы. Он выходит за рамки проверок доступности и включает метрики производительности, частоту ошибок и события безопасности. Ключевые практики включают:
- Оповещения в реальном времени:Немедленное уведомление команд при превышении пороговых значений.
- Агрегация логов:Централизация логов для упрощения анализа во время инцидентов.
- Базовые показатели производительности:Понимание нормального поведения для быстрого обнаружения аномалий.
🚀 Будущая защита архитектуры
Ландшафт быстро меняется. Появляются новые угрозы, технологии развиваются. Устойчивая архитектура должна быть достаточно гибкой, чтобы адаптироваться.
Адаптивность и масштабируемость
Проектирование с учетом роста и изменений. Системы должны масштабироваться горизонтально для обработки возросшей нагрузки без необходимости полного перепроектирования. Это включает использование облачно-нативных паттернов, которые позволяют динамически добавлять или удалять ресурсы.
- Контейнеризация:Упаковка приложений вместе с их зависимостями, обеспечивая согласованность во всех средах.
- Оркестрация:Автоматическое управление развертыванием и масштабированием контейнеров.
- Серверные вычисления:Устраняет необходимость управления серверами, позволяя сосредоточиться на логике.
Управление знаниями
Люди покидают организации. Институциональные знания должны быть сохранены. Документирование архитектуры, процедур восстановления и обоснований решений гарантирует, что новые команды смогут поддерживать и улучшать систему, не полагаясь на устные традиции.
📌 Краткое содержание лучших практик
Чтобы подвести итог пути к устойчивой корпоративной архитектуре, рассмотрите следующий контрольный список:
- ✅ Составьте карту всех зависимостей и определите единственные точки отказа.
- ✅ Определите четкие целевые показатели RTO и RPO на основе критичности бизнес-процессов.
- ✅ Внедрите механизмы избыточности и переключения на резерв, соответствующие уровню риска.
- ✅ Автоматизируйте процессы восстановления, чтобы снизить количество человеческих ошибок и время простоя.
- ✅ Интегрируйте средства защиты непосредственно в проект.
- ✅ Регулярно тестируйте планы восстановления с помощью симуляций и учений.
- ✅ Непрерывно мониторьте системы и подавайте сигналы при обнаружении аномалий.
- ✅ Документируйте все процессы и поддерживайте контроль версий.
Создание устойчивости требует инвестиций, времени и дисциплины. Речь идет не о предотвращении каждого сбоя, так как это невозможно. Речь идет о том, чтобы обеспечить возможность организации продолжать обслуживать своих клиентов и заинтересованных сторон при возникновении сбоев. Внедряя эти принципы в основу корпоративной архитектуры, лидеры могут гарантировать, что их организации останутся стабильными, безопасными и готовыми к любым предстоящим вызовам.
Путь к устойчивости непрерывен. По мере изменения среды архитектура также должна меняться. Регулярные обзоры, обновления и улучшения поддерживают надежность системы. Такой проактивный подход превращает архитектуру из статичного чертежа в динамичный актив, который способствует созданию бизнес-ценности и стабильности.

