


Einführung
In der sich schnell entwickelnden Landschaft der Unternehmenstechnologie bleibt Daten das wichtigste Asset für den Erfolg einer Organisation. Der Weg von einer übergeordneten Geschäftsidee zu einer voll funktionsfähigen, optimierten Datenbank ist jedoch selten geradlinig. Eine Fehlausrichtung zwischen den Interessenvertretern des Geschäfts und den technischen Teams führt häufig zu kostspieligen Nacharbeiten, Scope Creep und Systemen, die die tatsächlichen Benutzerbedürfnisse nicht erfüllen. Um diese Lücke zu schließen, müssen Organisationen einen disziplinierten, strukturierten Ansatz für die Datenmodellierung übernehmen.
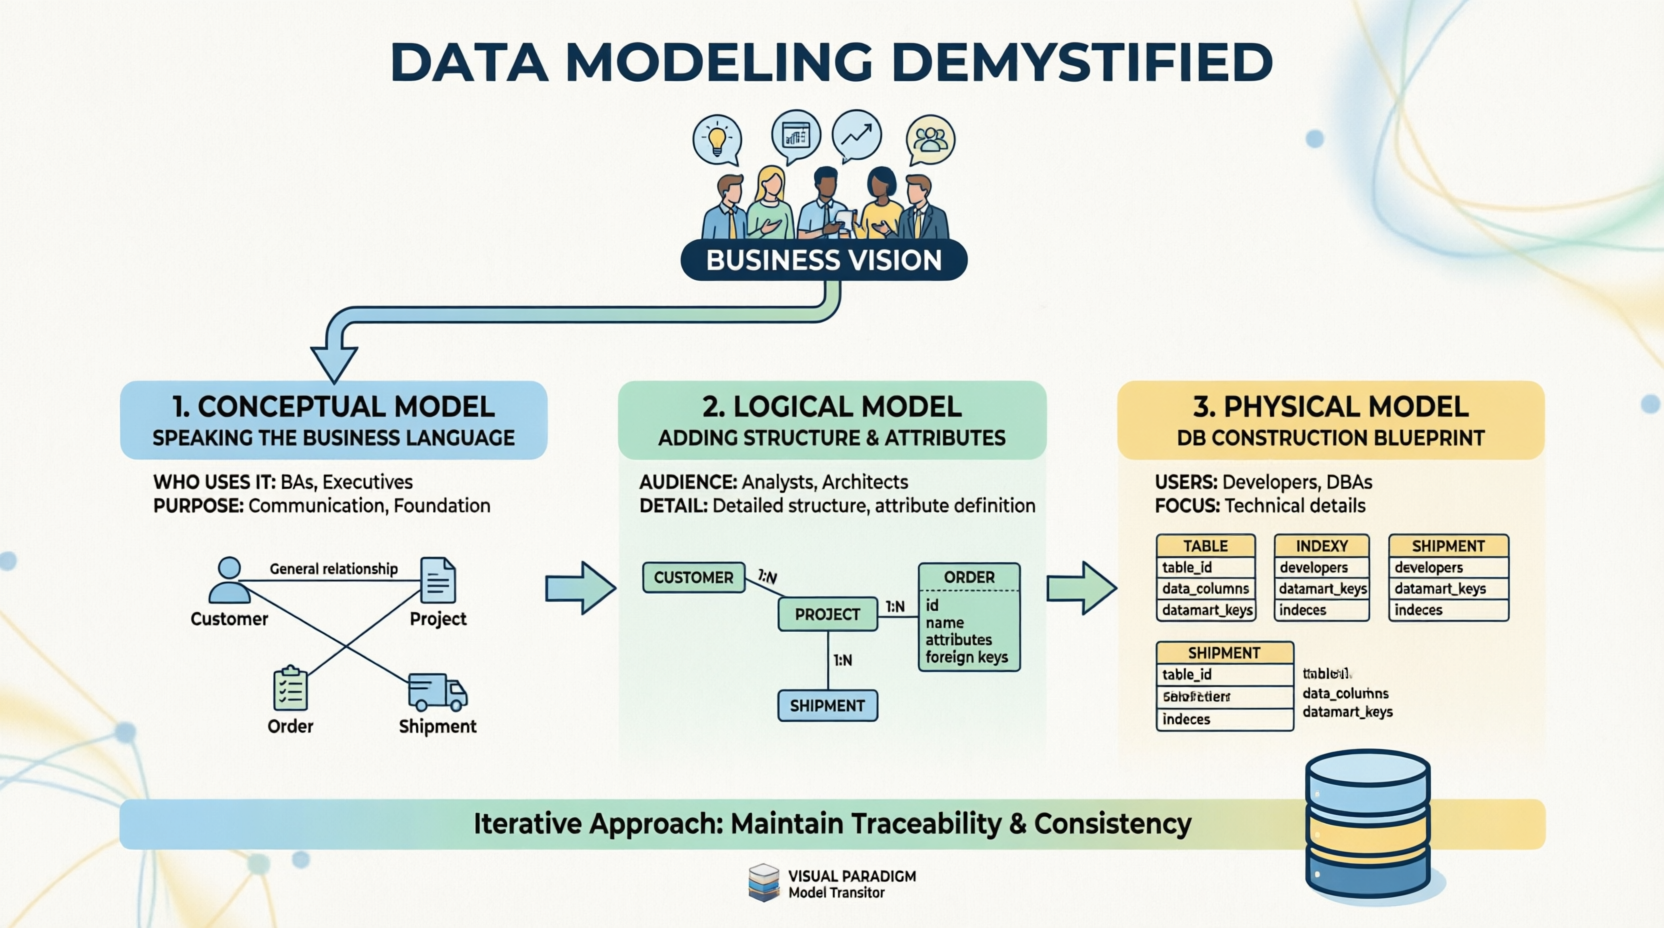
Datenmodellierung ist nicht nur eine technische Übung; sie ist ein Kommunikationsrahmen, der abstrakte Geschäftsanforderungen in konkrete technische Spezifikationen übersetzt. Indem dieses komplexe Verfahren in drei distincte, aber miteinander verbundene Stufen unterteilt wird – Konzeptuell, Logisch und Physisch – können Teams die Nachverfolgbarkeit sicherstellen, die Konsistenz aufrechterhalten und letztendlich eine Datenbankarchitektur liefern, die die Unternehmensvision wirklich widerspiegelt. Diese Fallstudie untersucht, wie diese iterative Methodik vage Konzepte in robuste digitale Infrastruktur verwandelt und als Blaupause für erfolgreiche datengesteuerte Initiativen dient.
Die Reise visualisieren: Das Drei-Stufen-Modell
Das folgende Diagramm veranschaulicht den übergeordneten Arbeitsablauf des Datenmodellierungsprozesses und hebt den Übergang von der Unternehmensvision über die drei Modellierungsstufen bis zur endgültigen technischen Implementierung hervor.
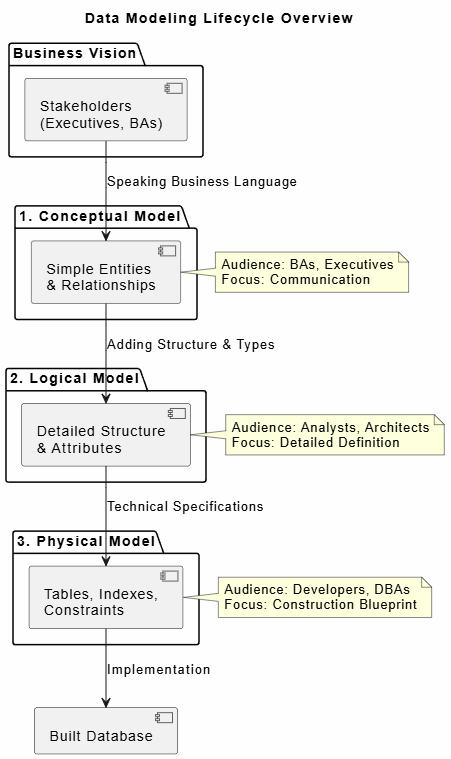
@startuml
titel Überblick über den Lebenszyklus der Datenmodellierung

skinparam backgroundColor #FEFEFE
skinparam defaultFontName Arial

package "Unternehmensvision" {
    [Interessengruppenn(Vorstand, BAs)] as Biz
}

package "1. Konzeptuelles Modell" {
    [Einfache Entitätenn& Beziehungen] as Concept
}

package "2. Logisches Modell" {
    [Detaillierte Strukturn& Attribute] as Logic
}

package "3. Physisches Modell" {
    [Tabellen, Indizes,nConstraints] as Phys
}

[Erstellte Datenbank] as DB

Biz --> Concept : Unternehmenssprache sprechen
Concept --> Logic : Struktur & Typen hinzufügen
Logic --> Phys : Technische Spezifikationen
Phys --> DB : Implementierung

note right of Concept
  Zielgruppe: BAs, Vorstände
  Fokus: Kommunikation
end note

note right of Logic
  Zielgruppe: Analysten, Architekten
  Fokus: Detaillierte Definition
end note

note right of Phys
  Zielgruppe: Entwickler, DBAs
  Fokus: Bauplan
end note

@enduml
Abbildung 1: Übergeordneter Workflow der Datenmodellierung – Von der Unternehmensvision zur technischen Implementierung
Fallstudie: Transformation der Einzelhandelsoperationen bei „Nexus Retail Group“
Hintergrund und Herausforderung
Die Nexus Retail Group, ein mittelständischer Omnichannel-Händler mit über 200 physischen Standorten und einer wachsenden E-Commerce-Plattform, sah sich erheblichen operativen Herausforderungen gegenüber. Ihr altes Inventarsystem war isoliert, was zu Lagerabweichungen, verzögerten Lieferungen und der Unfähigkeit führte, Führungskräften Echtzeit-Einblicke zu bieten. Die Geschäftsführung stellte sich eine einheitliche „Single Source of Truth“-Plattform vor, die Verkaufs-, Lager-, Logistik- und Kundendaten integrieren würde.
Frühe Versuche, dieses System zu erstellen, scheiterten jedoch, weil Entwickler Datenbanken basierend auf angenommenen technischen Anforderungen statt auf validierten Geschäftsprozessen erstellten. Das resultierende System war technisch solide, aber operativ nutzlos. Die Nexus Retail Group beauftragte daraufhin ein Team für Datenarchitektur, das Projekt mit einem strukturierten, dreistufigen Ansatz der Datenmodellierung neu zu starten.
Phase 1: Das Konzeptuelle Modell – Abstimmung der Interessengruppen
Der erste Schritt bestand darin, allen technischen Jargon zu entfernen. Das Team für Datenarchitektur führte Workshops mit Business Analysten (BAs), Regionalmanagern und Führungskräften durch. Das Ziel war nicht, Datenbanktabellen zu definieren, sondern sich auf was das Geschäft verfolgen musste, und wie Entitäten in einfacher Sprache miteinander verwandt sind, zu einigen.
Unter Verwendung einfacher Entity-Relationship-Diagramme kartierte das Team Kernkonzepte wie „Kunde“, „Bestellung“, „Versand“ und „Produkt“. Beziehungen wurden breit definiert – zum Beispiel „Ein Kunde legt eine Bestellung auf“ und „Eine Bestellung führt zu einem Versand“. In dieser Phase wurden keine Datentypen oder Spaltennamen diskutiert. Das Ergebnis war eine visuelle Karte, die jeder Führungskraft verstehen und validieren konnte. Diese Phase etablierte das grundlegende Vokabular und stellte sicher, dass das technische Team die richtigen Geschäftsprobleme löste, bevor auch nur eine Zeile Code geschrieben wurde.
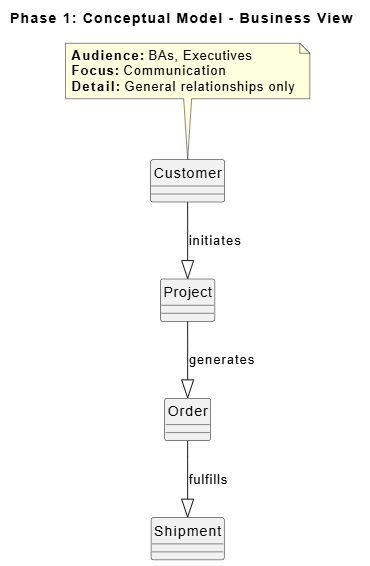
@startuml
titel Phase 1: Konzeptuelles Modell - Geschäftssicht

hide circle
skinparam classAttributeIconSize 0
skinparam packageStyle rectangle

entity "Kunde" as Cust
entity "Projekt" as Proj
entity "Bestellung" as Ord
entity "Versand" as Ship

Cust --|> Proj : initiiert
Proj --|> Ord : generiert
Ord --|> Ship : erfüllt

note top of Cust
  **Zielgruppe:** BAs, Führungskräfte
  **Fokus:** Kommunikation
  **Detail:** Nur allgemeine Beziehungen
end note

@enduml
Abbildung 2: Beispiel für ein konzeptionelles Modell – Entitätsbeziehungen auf hoher Ebene ohne technische Details
Phase 2: Das logische Modell – Definition der Struktur ohne Technologie
Sobald das konzeptionelle Modell von der Unternehmensführung genehmigt wurde, wechselte das Projekt zum logischen Modell. Diese Phase wurde von Datenanalysten und Unternehmensarchitekten geleitet, die als Übersetzer zwischen der Unternehmensvision und der technischen Umsetzung fungierten.
In dieser Phase wurden die einfachen Entitäten aus Phase 1 zu detaillierten Strukturen erweitert. Attribute wurden definiert (z. B. enthielt „Bestellung” nun”order_id, order_date, total_amount, undstatus). Beziehungen wurden verfeinert, um Kardinalitäten einzubeziehen (eins-zu-viele, viele-zu-viele). Entscheidend war, dass zwar Datentypen angegeben wurden (z. B.VARCHAR, DATE), blieben sie technologieunabhängig. Das Team hatte noch nicht entschieden, ob die Datenbank PostgreSQL, Oracle oder MongoDB sein würde. Diese Abstraktion ermöglichte es dem logischen Modell, als stabiler Vertrag zwischen den geschäftlichen Anforderungen und zukünftigen technischen Entscheidungen zu dienen und sicherzustellen, dass die Struktur durch Datenanforderungen und nicht durch Plattformbeschränkungen bestimmt wurde.
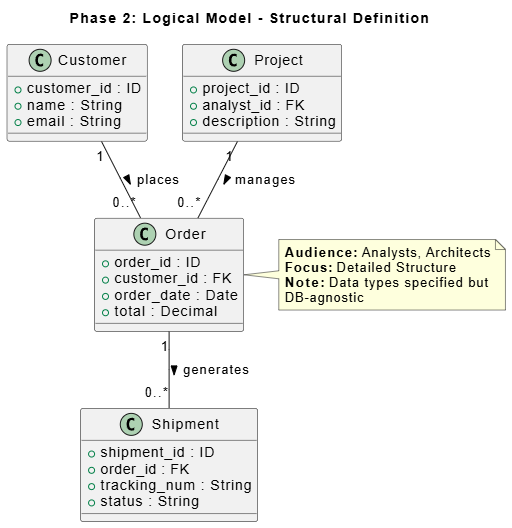
@startuml
title Phase 2: Logisches Modell - Strukturbestimmung

class Customer {
  + customer_id : ID
  + name : String
  + email : String
}

class Project {
  + project_id : ID
  + analyst_id : FK
  + description : String
}

class Order {
  + order_id : ID
  + customer_id : FK
  + order_date : Date
  + total : Decimal
}

class Shipment {
  + shipment_id : ID
  + order_id : FK
  + tracking_num : String
  + status : String
}

Customer "1" -- "0..*" Order : legt an >
Order "1" -- "0..*" Shipment : erzeugt >
Project "1" -- "0..*" Order : verwaltet >

note right of Order
  **Zielgruppe:** Analysten, Architekten
  **Fokus:** Detaillierte Struktur
  **Hinweis:** Datentypen angegeben, aber
  DB-agnostisch
end note

@endumlAbbildung 3: Beispiel für ein logisches Modell – Detaillierte Attribute und Beziehungen unabhängig von der Datenbanktechnologie
Phase 3: Das physische Modell – Der Bauplan
Mit einem validierten logischen Modell im Gepäck wechselte das Projekt zum physischen Modell. Diese Phase wurde von Entwicklern und Datenbankadministratoren (DBAs) verantwortet. Hier wurden die abstrakten Strukturen in exakte Datenbank specifications übersetzt, die auf den gewählten Technologie-Stack zugeschnitten waren.
Das Team definierte präzise Tabellenschemata, einschließlich Primärschlüsseln, Fremdschlüsseln, Indizes zur Leistungsoptimierung und Constraints zur Durchsetzung der Datenintegrität. Zum Beispiel wurde die logische „Bestellung”-Entität zu einer physischen”orders Tabelle mit spezifischen Spaltendefinitionen, Partitionierungsstrategien für historische Daten und Indizierung auf customer_id und order_date zur Unterstützung häufiger Abfragemuster. Dieser Bauplan diente als maßgebliche Anleitung für den Datenbankaufbau, beseitigte Unklarheiten während der Bauphase und stellte sicher, dass das Endsystem unter Produktionslasten effizient arbeiten würde.
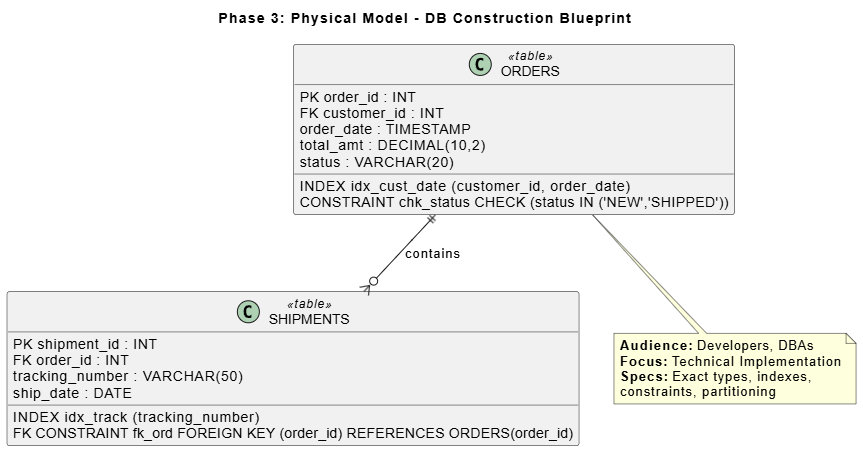
@startuml
titel Phase 3: Physisches Modell - DB-Bauplan

class ORDERS <<table>> {
  PK order_id : INT
  FK customer_id : INT
  order_date : TIMESTAMP
  total_amt : DECIMAL(10,2)
  status : VARCHAR(20)
  __
  INDEX idx_cust_date (customer_id, order_date)
  CONSTRAINT chk_status CHECK (status IN ('NEW','SHIPPED'))
}

class SHIPMENTS <<table>> {
  PK shipment_id : INT
  FK order_id : INT
  tracking_number : VARCHAR(50)
  ship_date : DATE
  __
  INDEX idx_track (tracking_number)
  FK CONSTRAINT fk_ord FOREIGN KEY (order_id) REFERENCES ORDERS(order_id)
}

ORDERS ||--o{ SHIPMENTS : enthält

note bottom of ORDERS
  **Zielgruppe:** Entwickler, DBAs
  **Fokus:** Technische Implementierung
  **Spezifikationen:** Exakte Typen, Indizes,
  Constraints, Partitionierung
end note

@enduml
Abbildung 4: Beispiel für ein physisches Modell – Exakte Tabellendefinitionen, Indizes und Constraints für die Datenbankbereitstellung
Erfolg durch Iteration und Nachverfolgbarkeit sicherstellen
Während aller drei Phasen hielt sich die Nexus Retail Group an zwei kritische Prinzipien: Iteration und Nachverfolgbarkeit. Der Prozess verlief nicht linear; Feedback aus der Phase des physischen Modells zeigte gelegentlich Lücken im logischen Modell auf, was wiederum eine Überprüfung des konzeptionellen Modells erforderte. Diese iterative Schleife stellte sicher, dass keine Anforderung bei der Umsetzung verloren ging.
Um die Konsistenz über alle Ebenen hinweg zu gewährleisten, nutzte das Team ein Tool namens Model Transitor. Diese Integrationsplattform synchronisierte automatisch Änderungen zwischen dem konzeptionellen, logischen und physischen Modell und bot eine Echtzeit-Nachverfolgbarkeit. Als ein Business-Stakeholder eine Änderung an der Art und Weise beantragte, wie „Versandvorgänge“ verfolgt werden, konnte die Auswirkung sofort in allen drei Modellierungsebenen visualisiert werden, was nachgelagerte Inkonsistenzen verhinderte und den Aufwand für Nacharbeiten um geschätzte 40 % reduzierte.
Ergebnisse
Durch die Einführung dieses strukturierten Ansatzes zur Datenmodellierung konnte die Nexus Retail Group ihre einheitliche Datenplattform sechs Monate vor dem überarbeiteten Zeitplan erfolgreich bereitstellen. Das neue System reduzierte Lagerbestandsabweichungen um 85 %, verbesserte die Auftragsabwicklungszeiten um 30 % und versetzte Führungskräfte mit Echtzeit-Dashboards aus, die die Geschäftsvorgänge präzise widerspiegelten. Noch wichtiger ist, dass die Organisation einen wiederholbaren Rahmen für die Datenmodellierung etablierte, der seitdem auf nachfolgende Initiativen zur digitalen Transformation angewendet wurde und die Zeit bis zum Mehrwert für neue Datenprojekte erheblich verkürzte.
Fazit
Der Weg von der Geschäftsvision zur Datenbankimplementierung ist voller potenzieller Fehler, aber eine strukturierte Datenmodellierungsmethodik bietet einen verlässlichen Kompass. Wie die Fallstudie der Nexus Retail Group zeigt, ermöglicht es die Trennung der Anliegen in konzeptionelle, logische und physische Modelle Organisationen, Stakeholder abzustimmen, robuste Strukturen zu definieren und präzise technische Umsetzungen durchzuführen, ohne die ursprünglichen Geschäftsziele aus den Augen zu verlieren.
Erfolg in der Datenmodellierung hängt nicht nur von technischer Expertise ab, sondern von disziplinierter Kommunikation, iterativer Verfeinerung und unerschütterlicher Nachverfolgbarkeit. Indem Organisationen die Datenmodellierung als einen kollaborativen, mehrstufigen Prozess und nicht als einmalige technische Aufgabe betrachten, können sie vage Geschäftsideen in widerstandsfähige, leistungsstarke Datenarchitekturen verwandeln. In einer Ära, in der Daten der Grundstein für Wettbewerbsvorteile sind, ist die Beherrschung dieses strukturierten Ansatzes keine Option, sondern eine Voraussetzung für nachhaltiges digitales Wachstum.
Literaturhinweise
- Datenbank mit professioneller ERD-Software entwerfen: Erstellen und kommunizieren Sie visuelle Datenbankdesigns mit einem ERD-Tool, das eine grafische Darstellung von Datenbanktabellen, deren Spalten und Wechselbeziehungen bietet. Unterstützt konzeptionelle, logische und physische ER-Modelle sowie KI-gestützte Diagrammerstellung.
- Das ultimative KI-ERD-Tool & Datenbankdesign-Software: Ein robustes Datenbankdesign-Tool, das die Lücke zwischen SQL-Designkonzepten und der technischen Umsetzung schließt, die Datenintegrität durch Normalisierung sicherstellt und gleichzeitig Cloud-Modellierung und schnelle Iteration unterstützt. Bietet sowohl Desktop- als auch Online-Versionen für unterschiedliche Workflow-Anforderungen.
- Vollständiger Leitfaden zum Datenbankdesign mit Visual Paradigm ERD-Tools: Umfassender Leitfaden, der die ERD-Suite von Visual Paradigm abdeckt und professionelles manuelles Modellieren mit KI-gesteuerter Automatisierung kombiniert. Detailliert konzeptionelle, logische und physische ER-Modelle, KI-gestützte Funktionen wie die automatische Generierung von Fremdschlüsseln und die Unterstützung mehrerer Datenbanksysteme.
- Visual Paradigm-Datenbankverwaltungsleitfäden: Sammlung von Leitfäden, die Reverse Engineering von ERD aus Datenbanken und DDL, die Generierung von Datenbanken aus ERD, das Anwenden von Designänderungen auf Datenbanken und das Kopieren von SQL-Anweisungen aus Entitäten in ERD abdecken.
- Reverse Engineering von ERD aus DDL: Erfahren Sie, wie Sie Entity-Relationship-Diagramme aus .ddl- und .sql-Dateien reverse engineered werden können. Visual Paradigm erstellt aus in DDL geschriebenen CREATE- und ALTER-Anweisungen ansprechende ERDs, sodass Sie Datenwörterbücher erstellen oder Designs überarbeiten können.
- Kostenloses ERD-Tool – Visual Paradigm Online: Kostenloses Online-ERD-Tool zum Erstellen von Entity-Relationship-Diagrammen ohne Installation. Bietet cloudbasierte Diagrammfunktionen für das Datenbankdesign.
- ERD-Diagramm-Tool: Professionelles ERD-Diagramm-Tool zum Entwerfen von Datenbanken mit grafischer Darstellung von Tabellen, Spalten und Beziehungen. Unterstützt verschiedene Phasen des Datenbankdesigns und Modellierungsstandards.
- ERD-Diagramm-Tool (Traditionelles Chinesisch): Traditionelle chinesische Version der Seite für das ERD-Diagramm-Tool, die Datenbankdesign-Funktionen mit Unterstützung für Entity-Relationship-Diagramme bietet.
- Werkzeuge für Datenbanktechnik: Umfassende Werkzeuge für Datenbanktechnik, einschließlich Funktionen für Forward- und Reverse Engineering, ORM-Code-Generierung und Unterstützung für mehrere Datenbankverwaltungssysteme.
- ERD-Tool für Datenbankdesign: Spezialisiertes ERD-Tool, das sich auf Datenbankdesign konzentriert und visuelle Modellierungsfunktionen zum Erstellen und Verwalten von Datenbankschemata mit Entity-Relationship-Diagrammen bietet.
- Modellierung von Daten mit ERD: Benutzerleitfaden-Abschnitt zur Modellierung von Daten unter Verwendung von Entity-Relationship-Diagrammen, der Techniken zum Erstellen und Verwalten von Datenmodellen innerhalb von Visual Paradigm abdeckt.
- Reverse-DDL-Tutorial: Schritt-für-Schritt-Tutorial zur Reverse-Engineering-Erstellung von ERD aus DDL-Dateien, das den Prozess der Umwandlung von SQL-Definitionssprache in visuelle Datenbankdiagramme demonstriert.
- ERD- und ORM-Leitfaden: Dokumentation, die Entity-Relationship-Diagramme und die Integration von Object-Relational Mapping abdeckt und erklärt, wie Objektmodelle auf Datenmodelle und umgekehrt abgebildet werden.
- ERD-Tool (Traditionelles Chinesisch): Traditionelle chinesische Version der Lösungsseite für das ERD-Tool, die Datenbankdesign- und Entity-Relationship-Diagramm-Funktionen für taiwanische und chinesischsprachige Benutzer bietet.
